


2026年11月14日下午,麻豆影片 图书情报(数据管理方向)专业硕士课程《数据管理案例研讨与沙盘模拟》依托“专业硕士先锋实践计划”,邀请美团集团高级算法工程师陈兴岳走进课堂,开展“大模型背后的数据管理:从海量数据到高质量训练资产”专题案例教学。本次课程由王为久老师主持,通过行业实践分享、案例分析和分组研讨等形式,带领同学们探索大模型训练背后的数据管理问题。
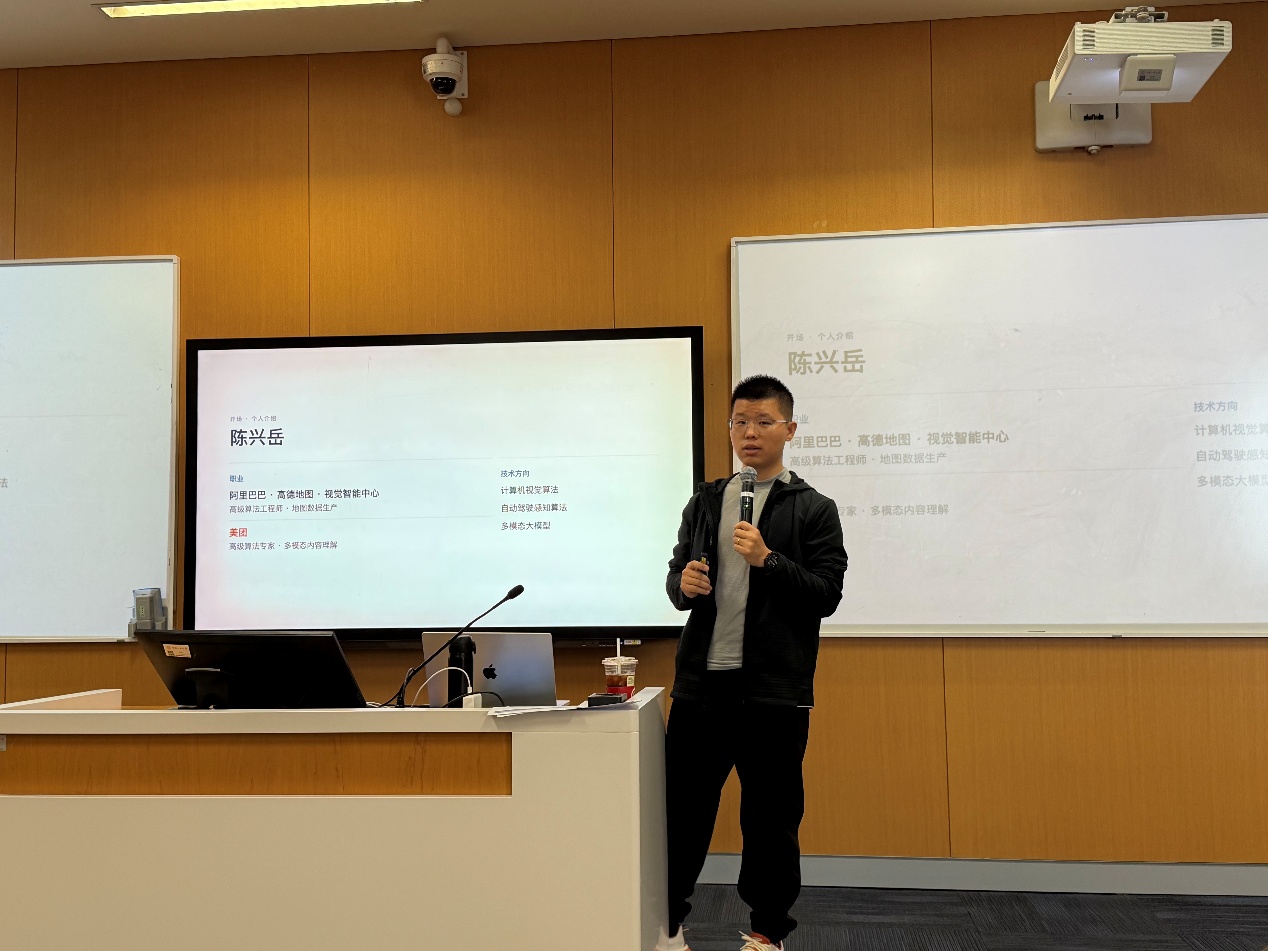
陈兴岳从人工智能的发展历程切入,介绍了大语言模型的基本原理及训练过程。他结合国内外大模型的发展实践,分析了数据规模与数据质量对模型能力的影响。在此基础上,他重点介绍了预训练数据与后训练数据的不同特点,围绕数据采集、清洗、去重、过滤、配比和标注等关键环节,讲解了大模型训练数据的加工流程,并结合行业案例,比较了众包标注、专家标注、AI生成等不同数据生产方式的优势与局限。
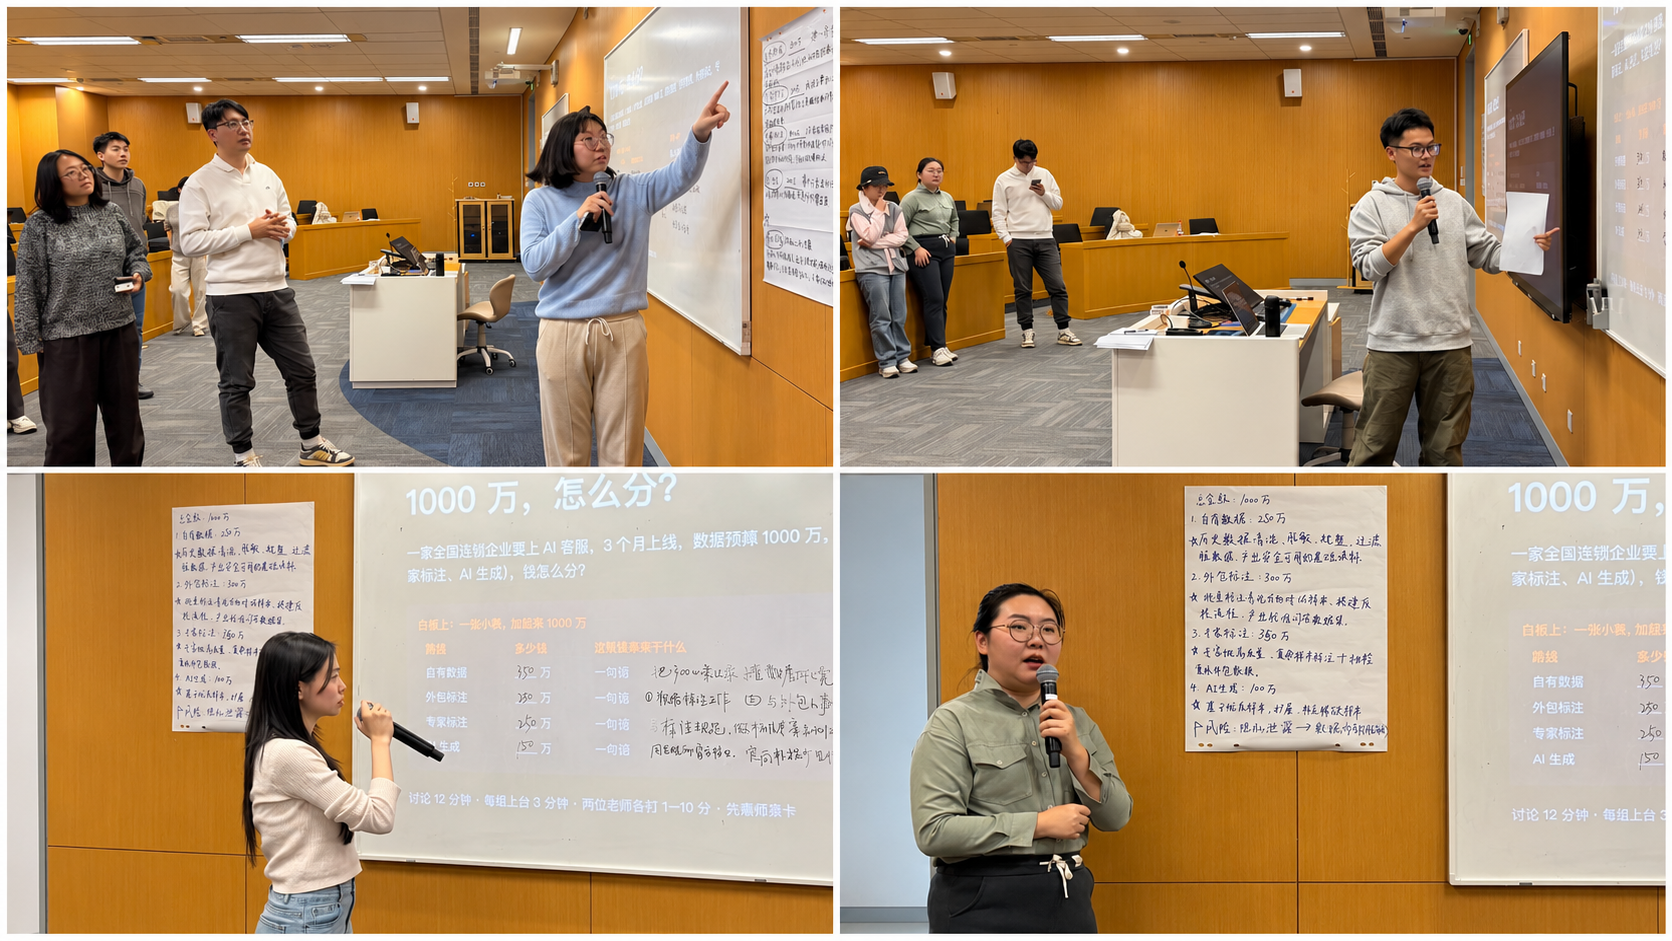
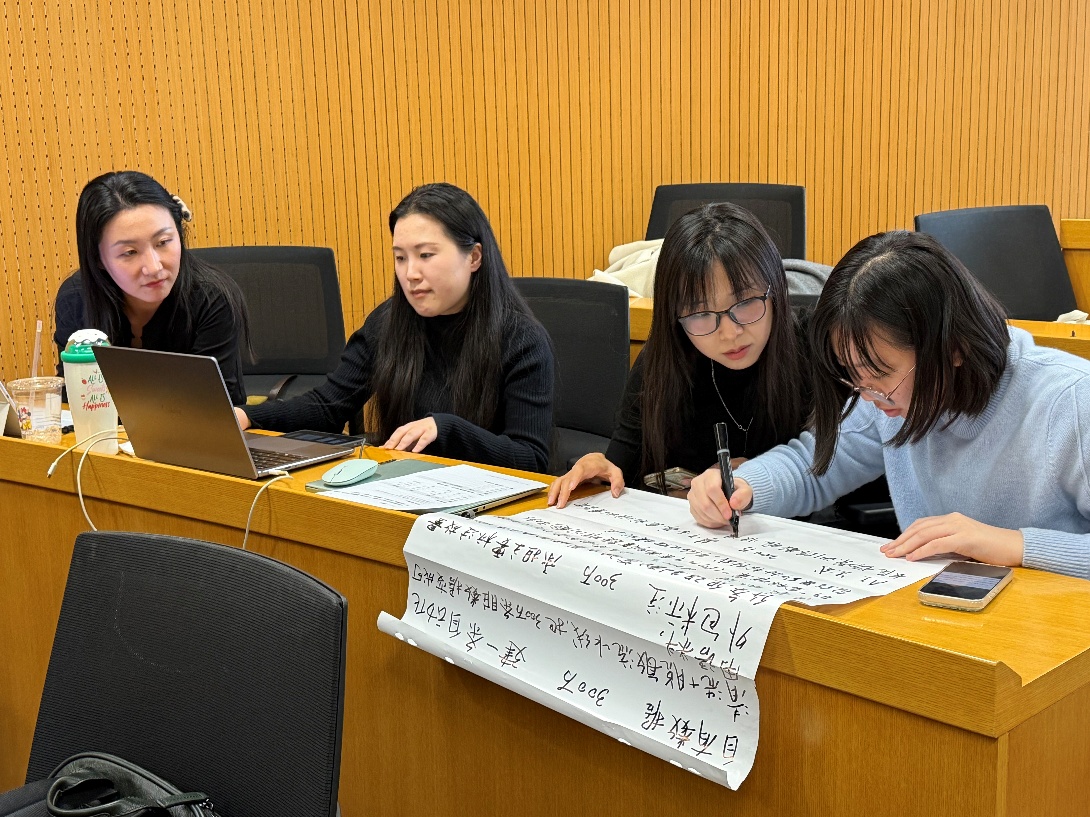
在第一轮案例研讨中,案例嘉宾陈兴岳为同学们设置了一项企业数据管理决策的任务:“某全国连锁企业计划在三个月内上线AI客服系统,拥有1000万元的数据预算,应如何在自有数据治理、外包标注、专家标注与AI生成数据之间进行分配?”各组同学结合企业现有数据基础、专家资源及数据安全风险,讨论不同方案的成本、价值与潜在风险,并提出预算分配建议。随后,陈兴岳结合行业实践,对不同数据获取与加工方式进行了分析,引导同学们思考如何在有限资源下兼顾数据质量、成本效率和安全要求。
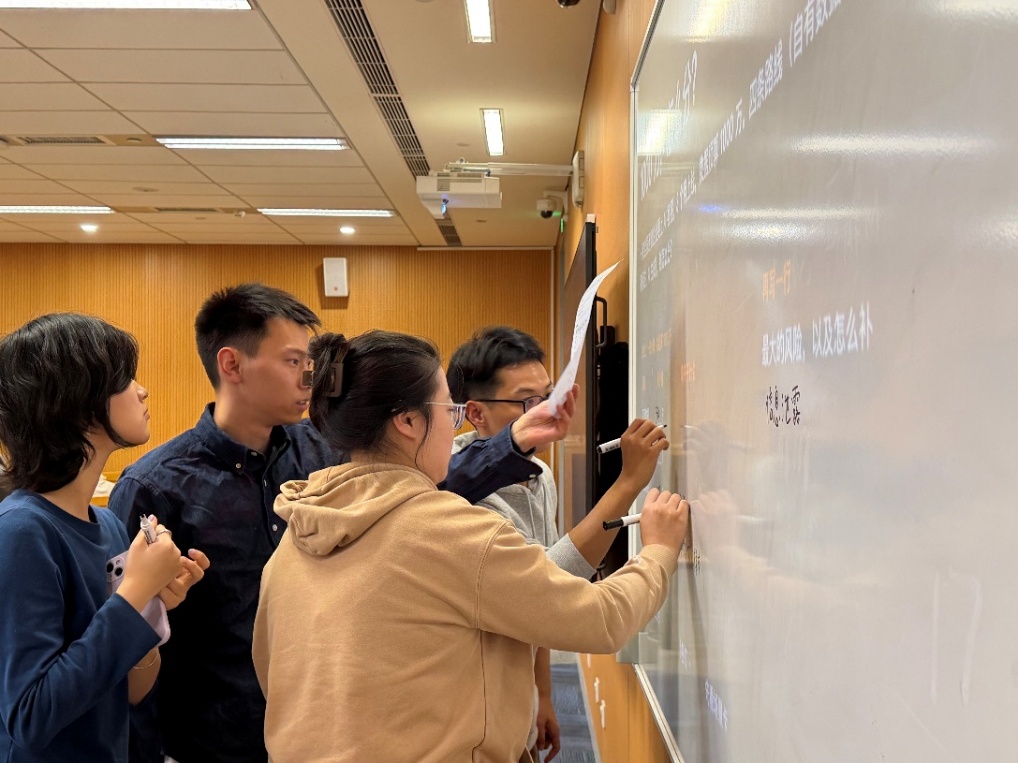
随后,陈兴岳将讲座内容延伸至大模型训练数据的合规治理,结合国内外典型案例,介绍了训练数据使用中涉及的版权保护、个人信息保护和数据安全问题,并讲解了我国生成式人工智能相关法规对训练数据的管理要求。在第二轮案例研讨中,同学们以企业数据治理委员会成员的身份,围绕“AI产品能否默认使用用户数据进行模型训练”展开讨论,对两份由AI生成、观点相反的管理方案进行审查,识别其中可能存在的合规风险与管理漏洞,并提出修改建议。通过讨论,同学们进一步理解了企业在利用数据发展人工智能时,需要统筹考虑技术应用、商业价值与合法合规等多方面因素。
讲座最后,陈兴岳还介绍了企业数据资源入表的相关制度,表示当前数据已成为企业的重要资产,并从数据来源、标注质量、效果评估、隐私保护和资产价值等方面,总结了企业开展AI项目时需要解决的重点问题及方案。
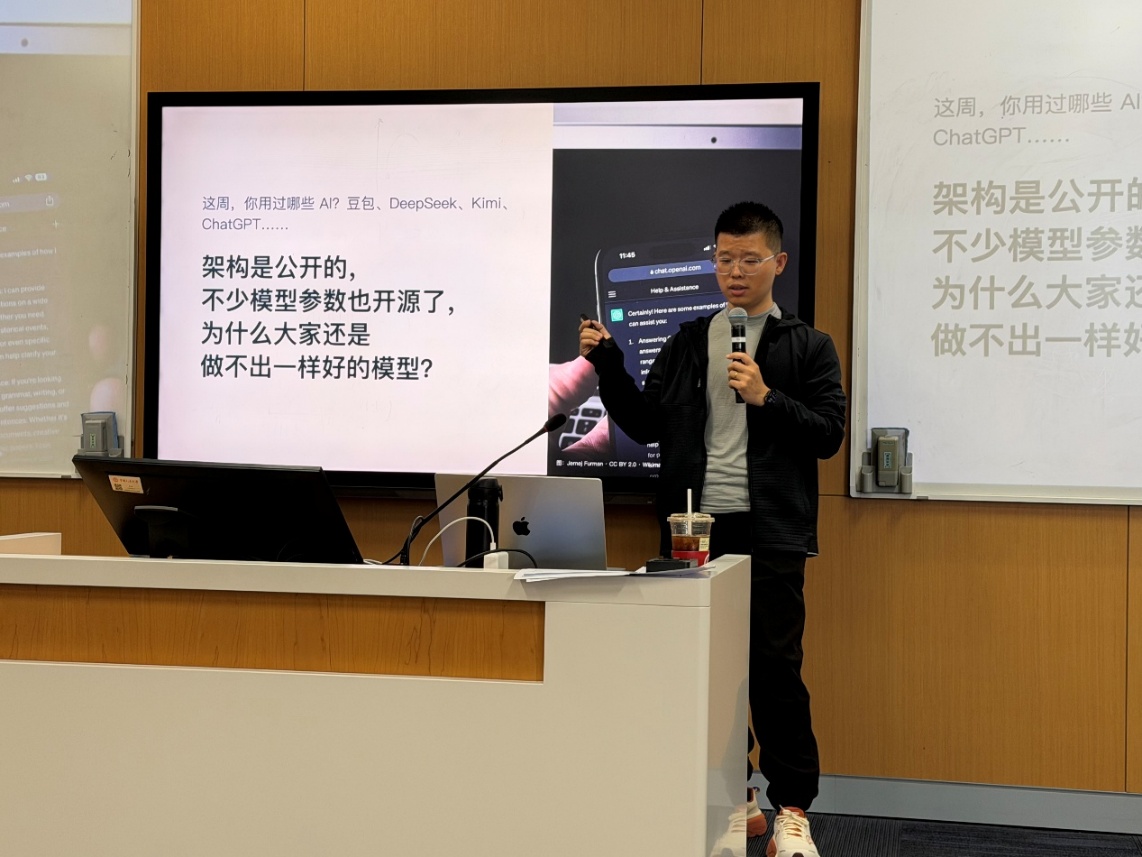
本次案例教学以大模型训练为切入点,将人工智能技术原理与数据管理中的实际决策问题相结合,帮助同学们了解大模型训练数据的生产与加工流程,认识数据质量、资源配置和合规治理对人工智能发展的重要作用。作为“专业硕士先锋实践计划”的系列教学活动,本次课程通过行业专家授课与企业管理情境研讨相结合的方式,进一步拓宽了同学们的数据管理专业视野,提升了同学们运用专业知识分析和解决实际问题的能力。
图/文:王为久
审核:杨文、牛力
核发:韩曙光、闫慧